Bloom
מבחן גיוס שנותן ציון לאופן שבו מועמד עובד עם AI, ובודק אם הוא תופס טעויות ששתלנו
40→85מתקרת AI נאיבי לרצפת פתרון מיודע
הבעיה
כשמועמדים עובדים עם AI, הגשה מלוטשת יכולה להסתיר כמה הם באמת הבינו. העבודה הגמורה לבדה אומרת מעט על איך הם כיוונו את המודל, בדקו את התשובות שלו או תיקנו את הטעויות שלו. וההחלטות האלה הן חלק ממה שצוות גיוס צריך להעריך.
גם התגובה המתבקשת, "תנו להם משימה ותנו להם להשתמש ב-AI", לא עובדת. אם שואלים את אותו AI פעמיים מקבלים תשובות שונות, אז אי אפשר להשוות בהוגנות בין שני מועמדים רק לפי הפלט של ה-AI. למשימות בית יש את הבעיה ההפוכה: הן לוקחות ימים, בדיקה שלהן עולה זמן של אנשים בכירים, ואפשר להעביר אותן לחבר.
מה בניתי
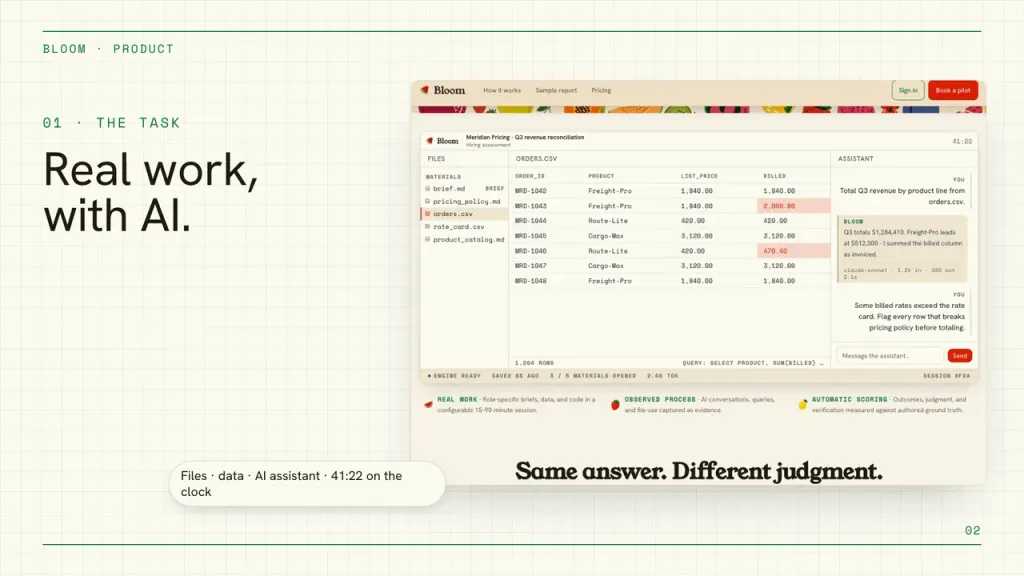
Bloom היא סימולציית עבודה מתוזמנת עם כללי ציון קבועים. המועמד מקבל משימה ריאליסטית עם בריף ודאטאסט קבועים, עובד עליה 15 עד 90 דקות עם AI ומגיש. הציון מגיע מכללים שמופעלים על העבודה, ולא מ-AI אחר ששופט אותה.
המועמד יכול לעבוד בשלוש דרכים: בצ'אט מתארח, דרך סוכן, או בכלי ה-AI שלו שמנותב דרך gateway. המצב משנה את הסביבה, לא את הציון.
הטריק שגורם לזה לעבוד
כל משימה נכתבת כך שנקודות הכשל הטבעיות של המודל יופעלו. שורות מלוכלכות בנתונים. סתירה בין שני מסמכי מקור. פרט באפיון שהפרומפט המתבקש מפספס. מספר שהמודל ימציא בביטחון מלא.
זה נותן לכל העסק תכונה שאפשר לבדוק, והבילד מותנה בתכונה הזאת:
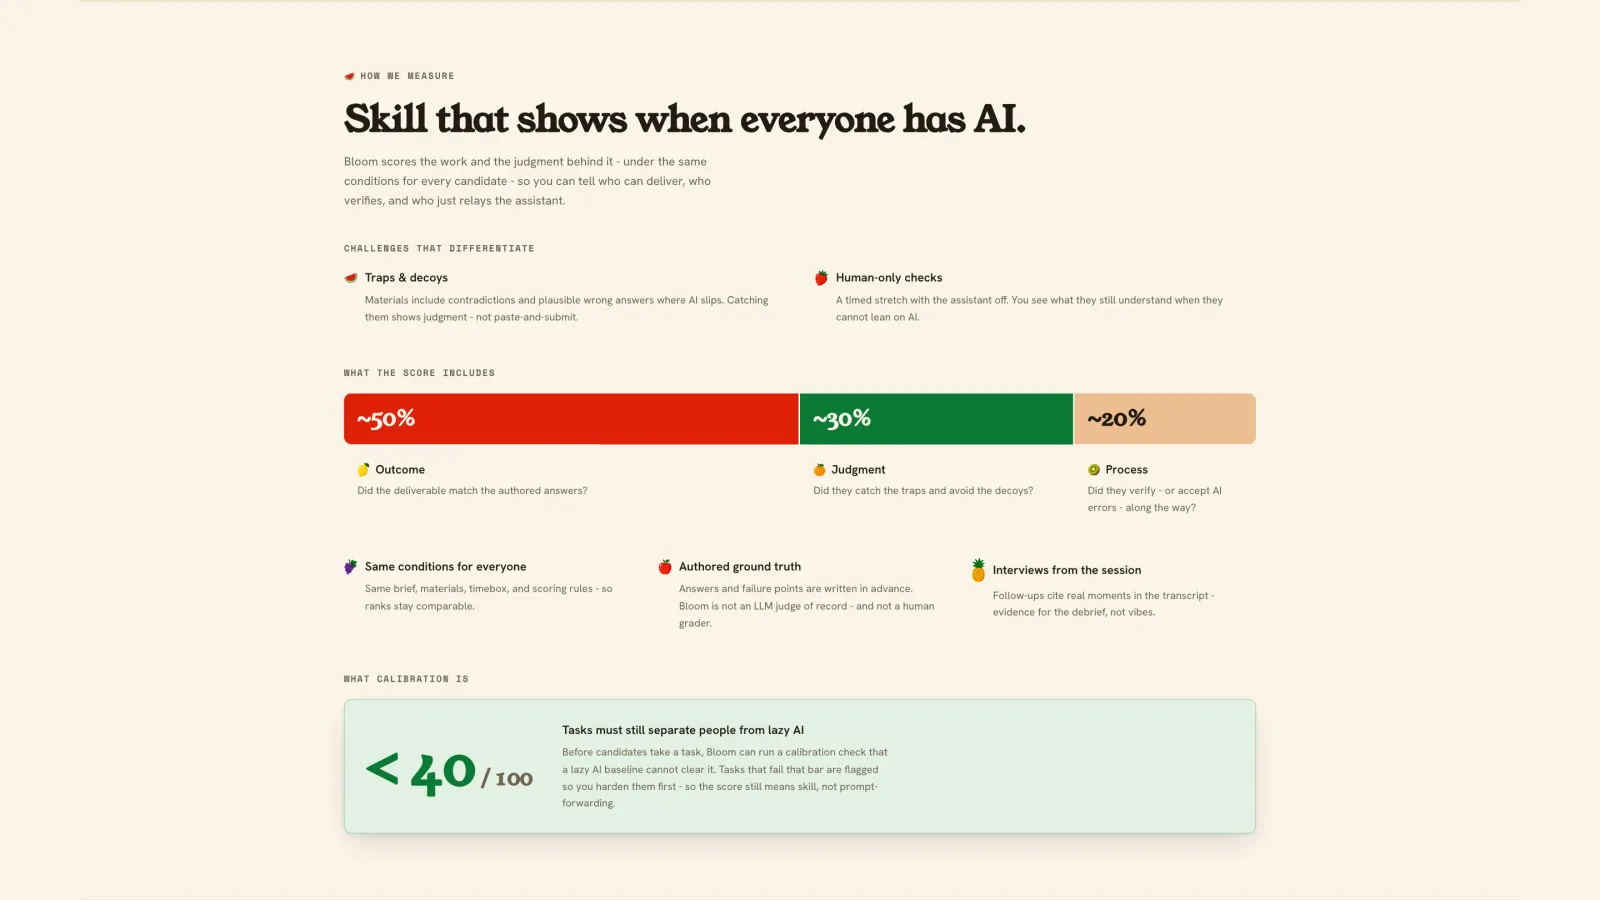
- הרצה נאיבית חייבת להיכשל. מסירה של הבריף ישירות למודל חייבת לקבל פחות מ-40 מתוך 100 בכל משימה, וזה נבדק לכל מודל כיול ב-CI. בשלוש המשימות שעלו לאוויר המודלים מקבלים 13, 26 ו-24 עם Gemini 3.5 Flash, ו-18, 23 ו-14 עם Gemini 3.1 Pro.
- עבודה מיודעת חייבת לעבור. אותן משימות, כשפותר אותן מישהו שתפס את המלכודות, חייבות לעבור 85 מתוך 100.
- הציון חייב להיות שחזורי. הרצה חוזרת של מנגנון הציון על סשן שמור חייבת להפיק דוח זהה ברמת הבייט. זו בדיקת דטרמיניזם בחבילת הטסטים, לא הבטחה.
אם משימה חדשה לא עומדת בשלושת התנאים, היא לא עולה. הכיול הוא שער, לא המלצה.
מה הדוח אומר
התוצר הוא לא מספר אחד. הוא מפריד בין התוצאה (האם התוצר יצא נכון), התפיסות (אילו כשלים שתולים המועמד שם לב אליהם ותיקן), וההתנהגות שנשלפת מהתמליל המלא של הסשן: איך הוא ניסח פרומפטים, כמה הוא אימת, ואיפה הוא קיבל פלט בלי לבדוק. התמליל הוא הראיה, כך שכל טענה בדוח אפשר לעקוב חזרה לרגע מסוים בסשן.
איפה זה עומד
השערים האוטומטיים עוברים. מה שעדיין פתוח הוא החלק שאף טסט לא יכול לענות עליו: האם מועמדים אמיתיים בדרגות ותק שונות מתפזרים על טווח ציונים רחב מספיק, והאם מגייסים באמת יריצו את זה במקום משימת בית. בשביל זה צריך בני אדם, וזה אבן הדרך הבאה ולא תוצאה גמורה.